Niveles de servicio
Percus compromete un objetivo de disponibilidad y publica el rendimiento que mide. Esta página declara ambos, y la evidencia detrás de ellos.
Compromiso de disponibilidad
99,5% de disponibilidad mensual del servicio de viewer — los endpoints que el navegador del destinatario invoca para cargar y reproducir un video personalizado.
| Medición | Porcentaje de requests exitosos a los endpoints de configuración del video y de entrega del player, evaluado por minuto y agregado al mes. Un minuto cuenta como no disponible cuando más del 5% de sus requests falla. |
| Downtime permitido | 3,6 horas al mes |
| Exclusiones | Mantenimiento anunciado con al menos 48 horas de aviso; fallas de proveedores fuera del control de Percus; la red o el navegador del propio destinatario; uso por encima de los límites contratados. |
Los créditos por incumplimiento, si aplican, se definen en el acuerdo comercial y no en esta página.
Objetivos de recuperación
| Objetivo | Compromiso |
|---|---|
| RPO — máxima pérdida de datos ante una recuperación | 30 días |
| RTO — máximo tiempo para restablecer el servicio | 4 horas |
Las bases de datos tienen respaldo continuo con recuperación a un punto en el tiempo sobre una ventana de retención de 30 días, de modo que un problema detectado días después de ocurrido todavía se puede recuperar. Los assets de personalización se almacenan con versionado, y los datos por destinatario tienen respaldo continuo independiente de la base principal. Las bases de datos de producción están protegidas contra borrado accidental.
Rendimiento medido
Estos son objetivos internos, no compromisos contractuales. La velocidad de carga del video depende en parte de la red del propio destinatario, que Percus no controla ni mide. Publicamos lo que medimos para que las cifras se puedan verificar en vez de afirmarse.
Tiempo hasta el primer cuadro
Tiempo desde la carga de la página hasta que se pinta el primer cuadro del video personalizado, medido en navegadores reales.
| Percentil | Objetivo | Medido |
|---|---|---|
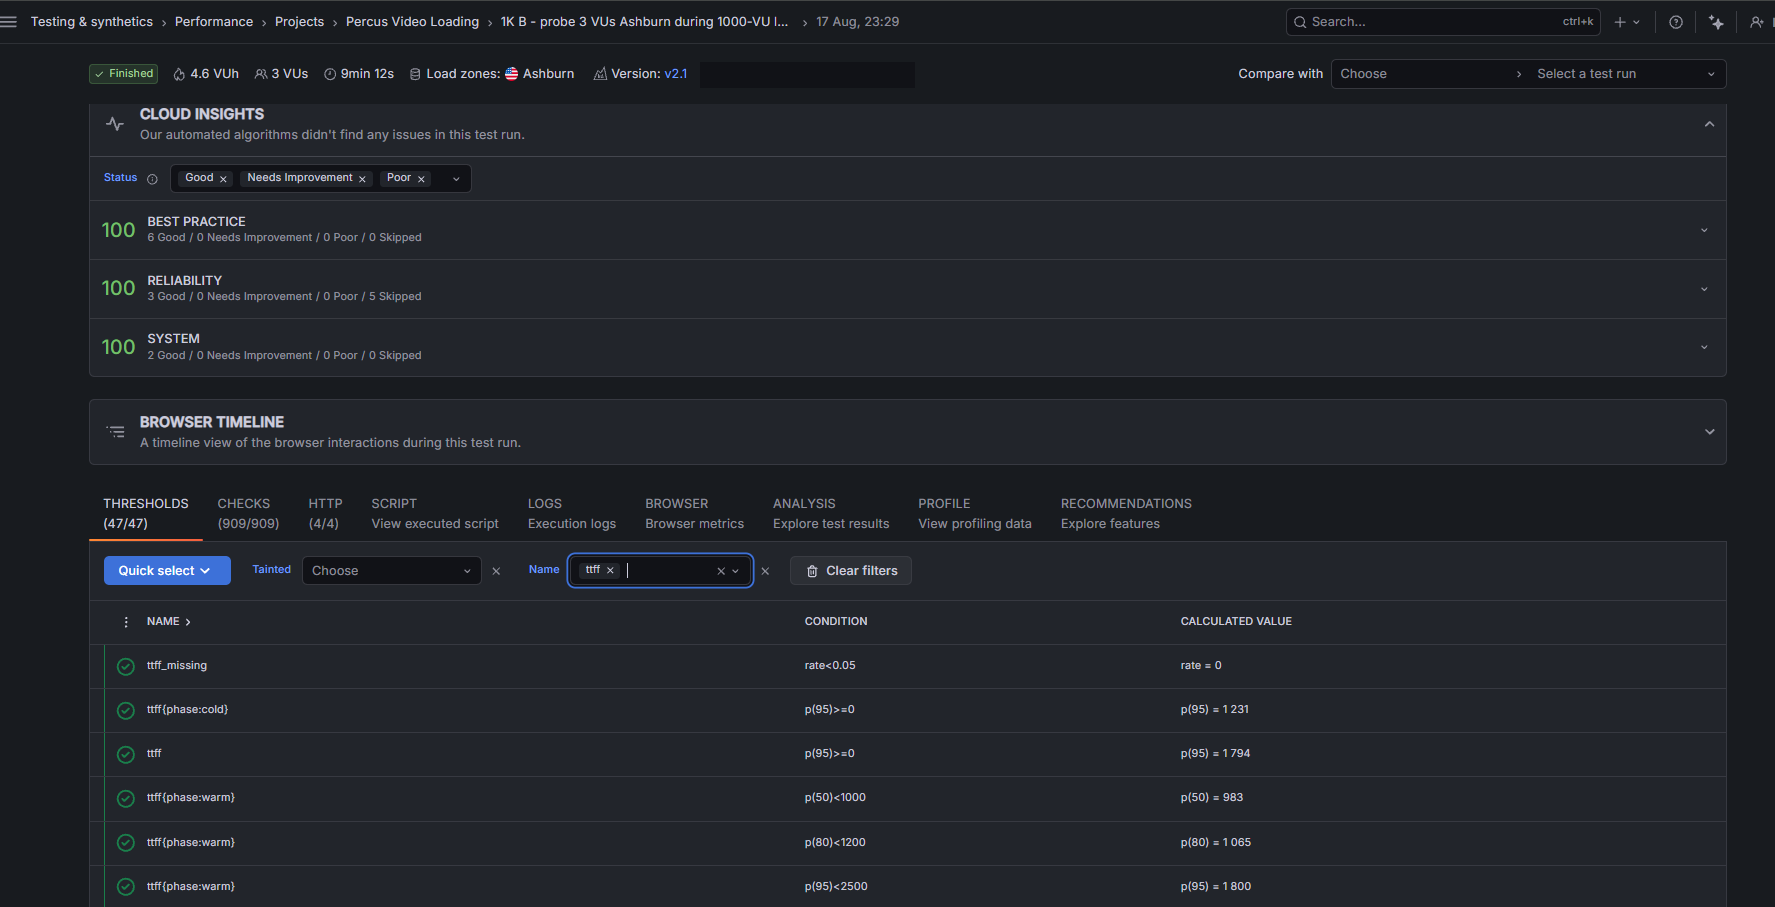
| p50 | < 1.000 ms | 860–983 ms |
| p80 | < 1.200 ms | 942–1.065 ms |
| p95 | < 2.500 ms | 1.040–1.800 ms |
Plataforma bajo carga
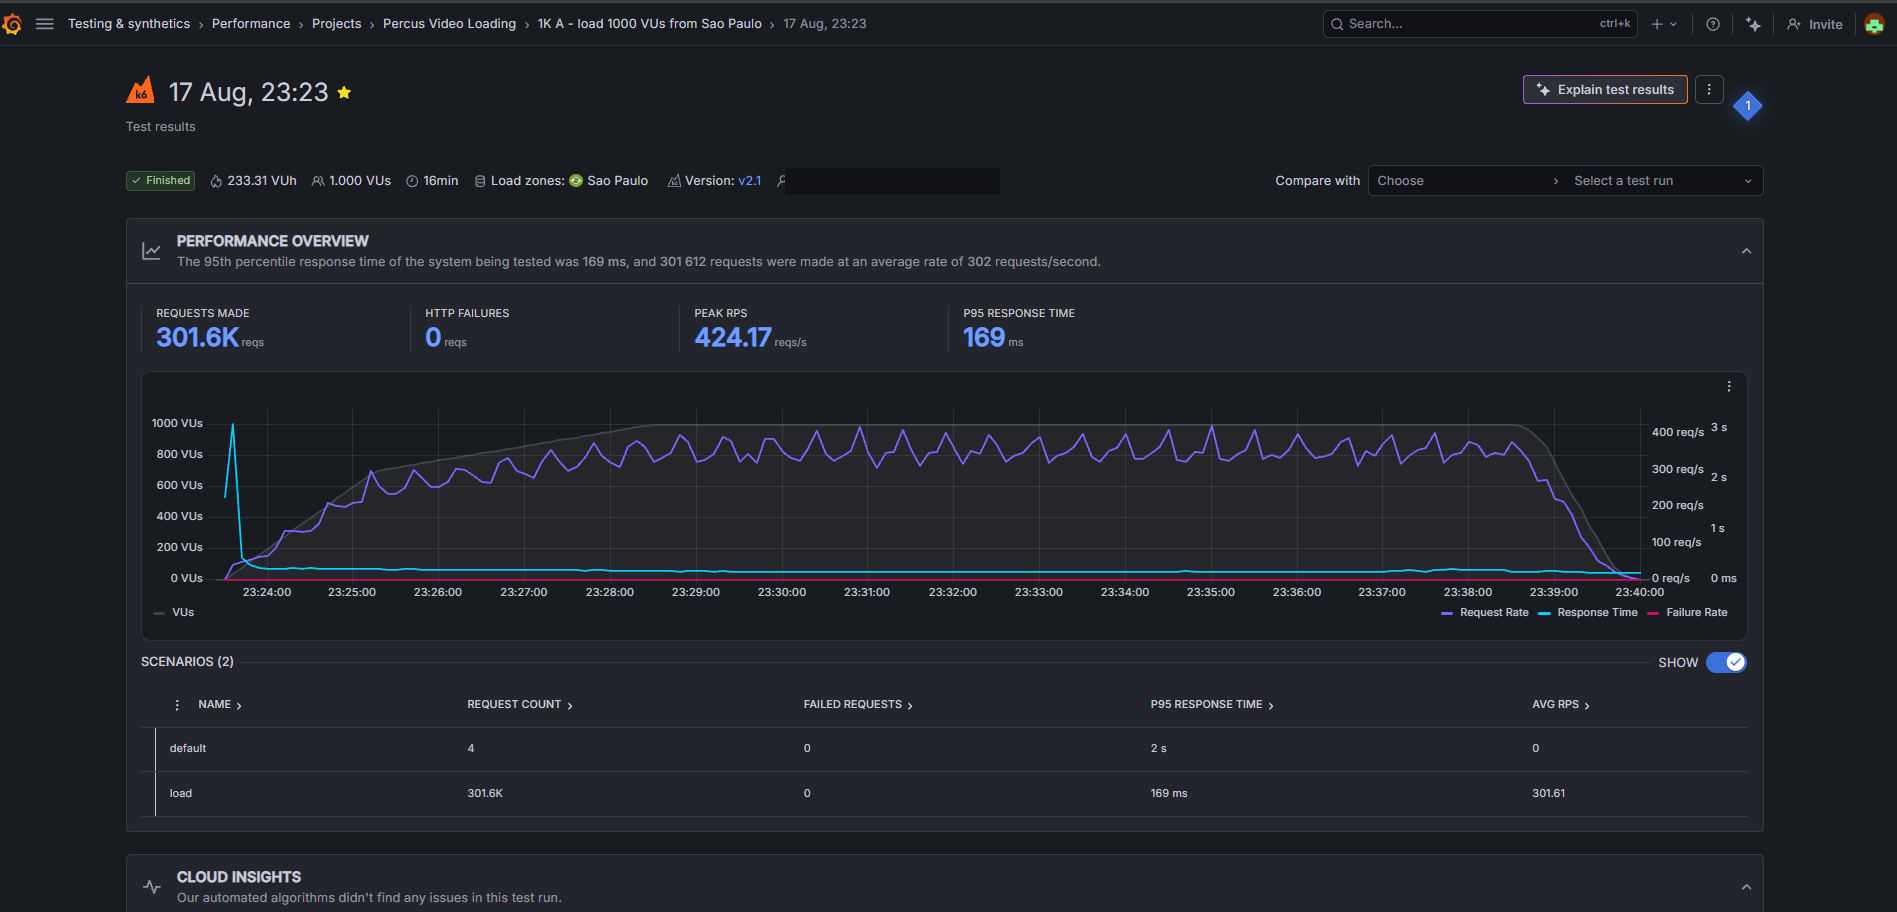
Medido con 1.000 usuarios virtuales concurrentes generando el patrón completo de requests de un viewer.
| Medido | |
|---|---|
| Requests atendidos | 301.612 |
| Requests fallidos | 0 |
| Throughput pico | 424 requests/segundo |
| Tiempo de respuesta de API (p95) | 169 ms |
El tiempo hasta el primer cuadro no se degradó bajo carga. Las mediciones sin carga y con 1.000 usuarios concurrentes quedan dentro de la varianza entre corridas.
Evidencia
Ambas corridas se ejecutaron con Grafana Cloud k6 e instrumentación de navegador real. La carga se generó desde São Paulo; las mediciones de navegador se tomaron desde otra región, de modo que los navegadores que miden no compitieran por recursos con los generadores de carga.
Carga: 1.000 usuarios virtuales concurrentes
Tiempo hasta el primer cuadro durante esa misma carga
Alcance de lo verificado
Declarado explícitamente, porque una cifra de capacidad sin su límite no sirve:
- Verificado: 1.000 viewers concurrentes, con la plataforma devolviendo cero errores y el tiempo hasta el primer cuadro dentro de los objetivos anteriores.
- Aún no verificado: el punto en que la plataforma sí empieza a degradarse. Las pruebas no se rampearon más allá de 1.000 viewers concurrentes, así que el techo todavía no se conoce.
- Las mediciones se tomaron contra el ambiente de staging, que corre la misma arquitectura que producción.
Objetivos de disponibilidad más altos requieren cambios de arquitectura que están en el roadmap. Esta página se actualizará cuando cambie el compromiso, y las mediciones se volverán a ejecutar en vez de arrastrarse.